Mein herdr-Setup: Was Cloud Native an der Entwicklungsarbeit ändert
Meine Coding-Agents laufen in herdr auf einer Ubuntu-VM, erreichbar von allen meinen Geräten. Die VM selbst ist aber ein von Hand gepflegtes Einzelstück. Am eigenen Setup prüfe ich, was Cloud Native für die Entwicklungsarbeit heißt und warum Agents die Frage dringlicher machen.
Auf dieser Seite
Über Cloud Native reden wir meist bei Produktionssystemen: Container, Kubernetes, Deployments. Die Definition der CNCF beginnt seit ihrer Fassung 1.1 von 2024 aber mit Praktiken statt mit Technologien. In ihrer Aufzählung steht das Entwickeln vorn: „develop, build, and deploy“. Gemeint ist das Entwickeln der Workloads, über den Arbeitsplatz sagt die Definition nichts. Ich stelle die Frage trotzdem: Was heißt Cloud Native für den Ort, an dem ich selbst entwickle?
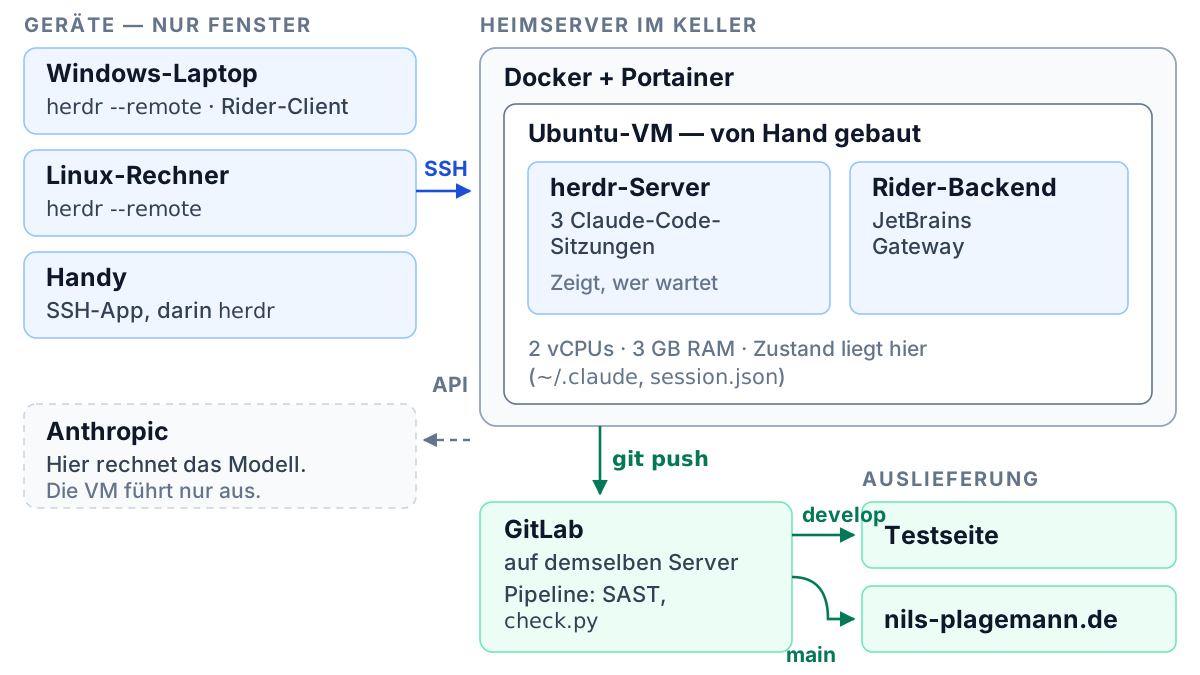
Mein Testfall ist mein eigenes Setup. Seit diesem Sommer laufen meine Coding-Agents in herdr auf einer Ubuntu-VM, und ich hänge mich vom Windows-Laptop, vom Linux-Rechner oder vom Handy an. Die Arbeit ist damit vom Gerät gelöst. Neu ist das nicht, screen und tmux können das seit Langem, aber das Setup erfüllt damit ein Merkmal, das NIST der Cloud zuschreibt: Zugang übers Netz von verschiedenen Geräten. Über das Setup laufen bisher nur private Projekte wie diese Website. Ob ich mir für die Arbeit ein ähnliches Setup aufbaue, überlege ich noch. Die VM selbst habe ich von Hand installiert, und das widerspricht dem, was Cloud Native verlangt. Im Beitrag über ephemere Testumgebungen habe ich beschrieben, wie eine Umgebung pro Pull Request aus Code entsteht und mit ihm wieder verschwindet. Meine VM entsteht nicht so.
Meine These: Ob Entwicklungsarbeit cloud-native ist, entscheidet sich weniger am Werkzeug als an zwei Fragen: Wo liegt der Zustand, und wer betreibt die Umgebung? Coding-Agents machen beide Fragen dringlicher. Grundlage sind mein Setup, wie es am 18. September 2026 lief, Doku und Quellcode von herdr 0.9.1 und die Doku der Agent-Anbieter (Stand September 2026).
Das Setup
Die Maschine ist eine gewöhnliche Ubuntu-VM. Wo sie läuft, spielt für das Setup keine Rolle, sie könnte genauso bei einem Cloud-Anbieter stehen. Bei mir steht sie auf dem Heimserver im Keller.
Darauf läuft herdr als Hintergrundserver. Ihm gehören die Terminals, in denen die Agents arbeiten, die Oberfläche ist nur ein Client, der sich anhängt und wieder löst. Pro Projekt gibt es einen Workspace, darin einen Tab pro Aufgabe. Im Workspace „Webseite“ laufen drei Claude-Code-Sitzungen, eine im Repo der Website und zwei im Repo der Inhalte.
Warum herdr und nicht tmux? Weiterlaufen, wenn der Laptop zugeht, kann tmux auch. Den Unterschied macht die Seitenleiste: Ich sehe auf einen Blick, welcher Agent auf mich wartet. Dazu nimmt herdr nach einem Neustart die Gespräche wieder auf. Und ich wollte das Werkzeug ausprobieren, bevor ich darüber urteile.
Angehängt bin ich auf drei Wegen: auf der VM selbst im Terminal, vom Windows-Laptop und vom Linux-Rechner mit herdr --remote, vom Handy über eine SSH-App. Bei --remote gehören die laufenden Panes weiter dem Server auf der VM. Der herdr auf dem Laptop zeichnet nur die Oberfläche, mit seinem eigenen Theme und seinen eigenen Tastenkürzeln. Technisch öffnet er eine SSH-Verbindung und startet auf der VM herdr remote-client-bridge. Mehrere Clients können gleichzeitig angehängt sein, jeder mit einem eigenen Workspace im Blick.
Die Konfiguration auf der VM ist kurz:
onboarding = false[ui.toast]delivery = "herdr"[theme]name = "solarized"auto_switch = false[ui]agent_panel_sort = "priority"onboarding = false trägt herdr nach der Ersteinrichtung selbst ein, auto_switch = false ist ohnehin voreingestellt, das Theme ist Geschmackssache. Auf die beiden übrigen Zeilen kommt es mir an. Mit delivery = "herdr" blendet herdr einen Hinweis ein, wenn ein Agent im Hintergrund fertig wird oder eine Eingabe braucht, standardmäßig ist das aus. Mit agent_panel_sort = "priority" sortiert die Seitenleiste die Agents nach Dringlichkeit statt nach Workspace.
Die Reihenfolge steht nicht in der Doku, sondern im Quellcode: zuerst blockierte Agents, die auf eine Freigabe oder Antwort warten, dann fertige, die ich noch nicht angesehen habe, dann arbeitende, dann fertige, die ich schon angesehen habe, zuletzt die, deren Zustand herdr nicht erkennt. Bei Gleichstand steht der Agent oben, dessen Zustand sich zuletzt geändert hat. Am 18. September wartete ein Agent auf eine Antwort, einer arbeitete, und einer war fertig und schon angesehen. Nach dieser Regel steht der wartende oben und der angesehene unten.
Den Zustand liest herdr bei Claude Code vom Bildschirm ab, mit Erkennungsregeln für das untere Ende des Terminals. Die Integration, die herdr integration install claude einrichtet, meldet seit herdr 0.6.7 nur noch die Kennung der Claude-Code-Sitzung: Ein Hook schickt sie beim Start an den Socket von herdr. Startet der herdr-Server neu und stellt sein Layout wieder her, ruft er im Pane claude --resume <id> auf, und das Gespräch geht weiter. Laufende Prozesse kommen dabei nicht zurück, nur Layout, Arbeitsverzeichnisse und Gespräche.
Die Last ist gering. Die VM hat zwei vCPUs und gut 3 GB Arbeitsspeicher. Der herdr-Server belegte davon 16 MB, jede Claude-Code-Sitzung zwischen 270 und 420 MB, die Systemlast (Load Average) lag bei 0,4. Das Modell rechnet beim Anbieter, die VM führt nur aus, was der Agent anstößt: Git, Builds, Tests. Solange das Kleinigkeiten sind, reicht eine kleine VM.
Was Cloud Native meint
Die CNCF definiert Cloud Native seit Februar 2024 so:
Cloud native practices empower organizations to develop, build, and deploy workloads in computing environments (public, private, hybrid cloud) to meet their organizational needs at scale in a programmatic and repeatable manner.
Dazu gehören lose gekoppelte Systeme, die sicher, resilient, handhabbar, nachhaltig und beobachtbar zusammenwirken. Als typische Techniken nennt die CNCF unter anderem Container, unveränderliche Infrastruktur und deklarative APIs, ausdrücklich ohne Anspruch auf Vollständigkeit. Die deutsche Übersetzung im selben Dokument gibt noch die Fassung von 2018 wieder, die von Technologien sprach.
Private Umgebungen schließt die Definition ein, und nach NIST darf eine Private Cloud auch im eigenen Haus stehen. Ich lese daraus: Cloud Native beschreibt ein Vorgehen, keinen Ort. Eine VM im Keller kann cloud-native betrieben werden, eine VM bei Azure kann es verfehlen. Umziehen allein hilft nicht. DORA fand 2024, dass ein bloßer Umzug in die Cloud, der ihre Flexibilität nicht nutzt, schädlicher sein kann als der Verbleib im klassischen Rechenzentrum.
Wie das Verfehlen aussieht, beschreibt DORA an einem Beispiel aus der Entwicklung:
For example, many organizations with cloud infrastructure do not allow developers to self-service their environments on demand: they require them to raise tickets or send emails and wait days for environments to be provisioned or for configuration changes to be made. In this case, although the organization may pay for a cloud service, they don’t have a cloud by NIST’s definition.
Das Gegenbild zur Selbstbedienung ist das Ticket. Das Problem habe ich allein nicht, ich bin meine eigene IT. Mir droht ein anderes: der gepflegte Einzelserver. Randy Bias hat dafür die Unterscheidung zwischen Pets und Cattle bekannt gemacht, die er selbst auf einen Vortrag von Bill Baker zurückführt. Pets (Haustiere) sind einzelne Server oder Serverpaare, die als unverzichtbar gelten und nie ausfallen dürfen, von Hand gebaut, verwaltet und gefüttert. Cattle (Nutzvieh) sind Verbünde aus mehr als zwei Servern, die mit automatisierten Werkzeugen gebaut und auf Ausfall ausgelegt sind.
Martin Fowler nannte den gewachsenen Einzelserver 2012 eine Schneeflocke, deren erstes Problem ist, dass sie sich kaum reproduzieren lässt. Als Gegenmittel empfahl er, die gesamte Konfiguration in automatisierten Rezepten zu halten und Phoenix-Server zu nutzen, die regelmäßig aus der Asche neu entstehen. Kief Morris zog 2013 die Konsequenz: ein Server, der nach dem Deployment nie verändert, sondern nur ersetzt wird. Eine Herde wird aus einer einzelnen VM nie. Erreichbar ist der Phoenix, eine Maschine, die regelmäßig aus ihrer Definition neu entsteht.
Lässt sich das auf einen Arbeitsplatz übertragen? Die Twelve-Factor App geht einen Schritt in diese Richtung: Auch die Kopie der Anwendung, die bei einem Entwickler lokal läuft, zählt dort als Deployment („each of which also qualifies as a deploy“). Gemeint ist die laufende Anwendung, nicht die Werkzeuge und Agents drumherum. Ich gehe weiter und lege die Maßstäbe probeweise an meine ganze Arbeitsumgebung an. Das ist meine Übertragung, nicht die der Quelle.
Mein Setup als Workload
| Eigenschaft | Herkunft | Mein Setup | Erfüllt |
|---|---|---|---|
| Zugang von jedem meiner Geräte | NIST: Broad network access | Laptop, Linux-Rechner und Handy hängen an derselben herdr-Sitzung, zu Hause wie unterwegs | ja |
| Beobachtbar | CNCF-Definition | Die Seitenleiste zeigt, welcher Agent wartet oder arbeitet, abgelesen vom Bildschirm. Speicher, Updates und Zustand der VM beobachtet niemand | halb |
| Wegwerfbare Prozesse | Twelve-Factor IX | Ein Neustart des herdr-Servers bricht laufende Agent-Arbeit ab. Layout und Gespräche kommen zurück, aber nur, weil sie auf der VM liegen | halb |
| Selbstbedienung auf Abruf | NIST, DORA | Ein neuer Agent ist in Sekunden da, eine neue VM nur in Handarbeit | halb |
| Zustandslos | Twelve-Factor VI | Gespräche und Layout liegen nur auf der VM | nein |
| Nichts geteilt | Twelve-Factor VI | Zwei Agents arbeiten im selben Checkout | nein |
| Aus Code gebaut, ersetzbar | CNCF, Fowler: Phoenix Server | Pakete, Docker, .NET, herdr und Agents von Hand installiert | nein |
| Entwicklung nah an Produktion | Twelve-Factor X | Die Pipeline baut die Website mit node:22-alpine, auf der VM läuft Node 22.22.1. Die Hauptversion stimmt, genauer legt keine Seite sie fest |
halb |
Oben steht, was herdr liefert, unten, was VM und Arbeitsweise schuldig bleiben. Ein klares Ja bekommt nur der Zugang. Die meisten übrigen Zeilen hängen an den beiden Fragen der These.
Wo der Zustand liegt
Twelve-Factor verlangt zustandslose Prozesse, die nichts miteinander teilen. Was bleiben soll, gehört in einen zustandsbehafteten Backing Service, denn ein Neustart löscht in der Regel allen lokalen Zustand in Speicher und Dateisystem. Mein einziger Backing Service ist das GitLab, und es kennt nur, was gepusht ist. Die Gespräche der Agents liegen unter ~/.claude auf der VM, Layout und Sitzungskennungen in der session.json von herdr, ebenfalls auf der VM. herdr sorgt dafür, dass dieser Zustand einen Neustart übersteht. Den Verlust der VM übersteht er nicht.
Kief Morris schreibt dazu:
If servers are disposable, the data that lives on them often is not.
Für mein Setup heißt das: Solange dieser Zustand nur auf der VM liegt, macht herdr die Sitzung haltbarer und damit die VM wertvoller. Ein Werkzeug, das Zustand bewahrt, macht die Maschine darunter dann zum Haustier: unverzichtbar, weil auf ihr liegt, was sonst nirgends liegt.
Zwei Agents, ein Checkout
Die zweite Hälfte von Faktor VI, nichts zu teilen, verfehle ich an anderer Stelle. Während dieser Beitrag entstand, arbeiteten zwei Claude-Code-Sitzungen im selben Checkout des Repos der Inhalte an verschiedenen Änderungen. In der Anleitung für die Agents dort steht deshalb die Regel, fremde Änderungen im Arbeitsverzeichnis nicht mit einzuchecken. Das ist ein Pflaster für fehlende Isolation.
An diesem Beitrag haben Agents mitgearbeitet. Sie haben recherchiert, Quellen geprüft, den Text lektoriert und auf Sprachfluss geprüft und daraus eine gut lesbare Endfassung gemacht. Von mir kommen das Thema, die Entscheidungen, wie der Beitrag verläuft, und eine Rohfassung, die holprig zu lesen war. Jede Fassung habe ich gelesen und entschieden, was drinbleibt.
Nichts teilen hieße hier: ein Git-Worktree pro Agent. herdr bringt das mit, herdr worktree create legt den Worktree an, öffnet ihn als eigenen Workspace und gruppiert ihn unter dem Repo. Claude Code kann es mit claude --worktree selbst. OpenAI führt es als typischen Fehler, mehrere laufende Aufgaben ohne Git-Worktrees auf denselben Dateien arbeiten zu lassen. Ein Worktree trennt allerdings nur die Dateien („They isolate file edits“, schreibt Anthropic). Ports, Datenbanken und Docker teilen sich die Agents weiter.
Was die Agents vergessen dürfen
Wie weit man den Zustand aus der Umgebung herausziehen kann, zeigen die Cloud-Agents der Anbieter. Für sie setzen alle großen Anbieter auf frische, isolierte Umgebungen, ihre CLIs laufen dagegen dort, wo man sie startet, bei mir auf der VM. Eine Cloud-Sitzung von Claude Code bekommt eine neue VM mit Ubuntu 24.04, die Anthropic nach einer Weile ohne Aktivität wieder abbaut. Öffnet man die Sitzung erneut, entsteht eine neue VM mit dem alten Gesprächsverlauf, laufende Hintergrundprozesse sind weg. Das ist Faktor VI in Reinform: Die Rechenumgebung trägt keinen Zustand, der Verlauf liegt beim Anbieter, der Code in Git.
Konsequent sind die Anbieter dabei nicht. Anthropic, OpenAI und Cursor cachen Umgebungen, um schneller zu starten: Anthropic etwa sieben Tage, OpenAI bei Codex bis zu zwölf Stunden, Cursor bewahrt Snapshots bis zu 90 Tage ohne Nutzung auf. Sie tauschen Wegwerfbarkeit gegen Startzeit.
Eine verwandte Regel kommt aus einer anderen Richtung. Auch auf derselben VM beginnt jede neue Claude-Code-Sitzung ohne Erinnerung, und lange Arbeit passt nicht in ein Kontextfenster. Anthropic lässt für lange Agent-Läufe deshalb den ersten Agent ein init.sh, eine Fortschrittsdatei und einen ersten Commit anlegen. Frische Umgebung und leeres Kontextfenster führen zum selben Schluss: Der Fortschritt gehört ins Repo, nicht ins Gespräch. Dann darf das Gespräch mit der VM sterben.
Wer die Umgebung betreibt
Das Gerät wird zum Fenster
Die sichtbarste Änderung an meiner Arbeit: Das Gerät, an dem ich sitze, ist nicht mehr der Ort der Arbeit. Klappe ich den Laptop zu, arbeiten die Agents weiter, und am Handy könnte ich sehen, wer auf mich wartet. Die Anbieter setzen auf dasselbe Muster. Bei Remote Control läuft Claude Code auf dem eigenen Rechner, und Anthropic nennt Browser und Handy „a window into that local session“. Cloud-Sitzungen von Claude Code laufen weiter, wenn man den Laptop schließt.
Selbst Code schreibe ich dabei kaum noch. Meine Arbeit ist vor allem, zu prüfen, was die Agents gebaut haben. Genau darin liegt die Gefahr des Handys: Wenn jeder fertige Agent Arbeit für mich bedeutet, schaue ich ständig nach, ob gerade etwas fertig geworden ist. Deshalb zwinge ich mich, nur vom Laptop aus zu arbeiten.
Der Preis ist eine Abhängigkeit. Ist der Heimserver aus, ist die Arbeit nicht erreichbar. Für ein einfaches herdr --remote dokumentiert herdr kein automatisches Wiederverbinden, das gibt es nur für gespeicherte Maschinen. Reißt nur die Verbindung ab, laufen die Agents weiter, und ich hänge mich neu an.
Eine zweite Maschine, die immer läuft
Den Laptop habe ich auch vorher selbst betrieben. Neu ist eine zweite Maschine, die immer laufen und übers Netz erreichbar sein muss: Updates, Backups, Zugänge und irgendwann die Frage, ob sie weg kann. Team Topologies nennt Fragen wie „How do I deploy this component again?“ extrinsische kognitive Last. Sie hängt an der Umgebung, nicht an der Aufgabe, und soll möglichst wegautomatisiert werden. Von Hand gepflegt bleibt sie liegen. Die Aspire-CLI etwa liegt auf meiner VM in Version 13.4.6 vom Juni, aktuell ist 13.5.4 vom 15. September. Was niemand neu baut, veraltet leise.
Das Werkzeug aus der Produktion ist dafür nicht automatisch das richtige. Gitpod hat Kubernetes für Dev-Umgebungen aufgegeben, weil sie stark zustandsbehaftet und interaktiv sind, unvorhersehbar Ressourcen brauchen und weitreichende Rechte verlangen. Die neue Plattform nutzt trotzdem eine Control Plane, die sich stark an Kubernetes anlehnt. Verworfen wurde das Werkzeug, nicht das Prinzip.
Für .NET zeigt Aspire, wie das Prinzip ohne Cluster in die tägliche Entwicklungsarbeit kommt. Laut Doku ist der AppHost keine Laufzeitumgebung für die Produktion, sondern ein Orchestrierungswerkzeug für die Entwicklungszeit. Er übersetzt den gewünschten Zustand der Anwendung in Ressourcen im Kubernetes-Format, die ein lokaler, Kubernetes-kompatibler API-Server abarbeitet, die Developer Control Plane (DCP). Das ist ein deklarativer Soll-Zustand ohne Kubernetes-Betrieb.
Auf meiner VM lief ein AppHost mit Containern neben den drei Agents ganz ok. Mit 8 GB Arbeitsspeicher würde es wahrscheinlich mehr Spaß machen.
Die Cloud nähme mir den Betrieb ab
Die Cloud-Agents der Anbieter würden mir den Betrieb abnehmen. Dafür verlangen sie eine Beschreibung der Umgebung. Ein Mensch weiß, was er auf seiner Maschine von Hand eingerichtet hat, und richtet es notfalls noch einmal ein. Einem Agent auf meiner VM fällt die Handarbeit nicht auf, was installiert ist, ist da. Ein Agent, der in einer frischen Umgebung startet, muss es erraten. GitHub begründet die Setup-Datei für seinen Cloud-Agent ausdrücklich mit der Arbeitsweise von Sprachmodellen:
Copilot can discover and install these dependencies itself via a process of trial and error, but this can be slow and unreliable, given the non-deterministic nature of large language models (LLMs)
Cognition nennt die Umgebungskonfiguration den wirksamsten Hebel für Devin, ohne sie sei es, als stelle man jemanden ein und gebe ihm keinen Laptop. Und Anthropic schreibt für Cloud-Sitzungen: Was nur auf dem eigenen Rechner installiert oder konfiguriert ist, fehlt dort, also gehört es ins Repo.
Wo diese Beschreibung liegt, ist nicht einheitlich. Die Setup-Skripte von Claude Code und Codex stehen in den Einstellungen des Anbieters. Copilot liest seine Schritte aus .github/workflows/copilot-setup-steps.yml im Repo, Cursor kann sie aus .cursor/environment.json lesen, und Claude Code kennt zusätzlich SessionStart-Hooks, die im Repo liegen und lokal wie in der Cloud laufen. Scheitert bei Copilot ein Setup-Schritt, arbeitet der Agent mit dem, was bis dahin steht. Der Druck zur Umgebungsdefinition ist da, ein gemeinsamer Ort dafür noch nicht.
Für mich kommt eine praktische Grenze dazu. Cloud-Sitzungen von Claude Code klonen nur von GitHub, ein anderes Repo lässt sich nur als Bundle hineinschicken, und zurückpushen kann die Sitzung dann nicht. Der Cloud-Agent von Copilot arbeitet nur mit Repos auf GitHub. Andere Anbieter binden selbst betriebenes GitLab an, müssen es dann aber aus ihrer Cloud erreichen. Mein Blog liegt in einem selbst betriebenen GitLab, also bleibt die eigene VM, und mit ihr der Betrieb.
Die Studienlage stützt die Richtung, mehr nicht. DORA beschreibt KI 2025 als Verstärker: „AI doesn’t fix a team; it amplifies what’s already there.“ Nur bei hoher Plattformqualität schlägt die Nutzung von KI in den Daten spürbar positiv auf die Leistung der Organisation durch, bei niedriger kaum. Das ist eine Korrelation über Organisationen, kein Befund über einzelne Arbeitsplätze. Die Übertragung auf meine VM ist meine Deutung.
Was sich ändern ließe
Die Bewertung oben zeigt, wo das Setup abweicht. Ob sich der Umbau lohnt, sagt sie nicht. An der VM arbeite nur ich, eingerichtet habe ich sie einmal, in diesem Sommer. Gegen ihren Verlust hilft auch ein Snapshot auf dem Heimserver, und der ist schnell gemacht. Gitpods Befund lässt sich sogar für das Einzelstück lesen: Dev-Umgebungen sind nun einmal zustandsbehaftet und interaktiv. Ein Snapshot stellt aber das Einzelstück wieder her, samt allem, was sich unbemerkt angesammelt hat. Ein Neubau aus Code macht diesen Stand sichtbar und kostet dafür Pflege bei jeder neuen Werkzeugversion.
Mir reicht ein Backup der VM, das ich jeden Morgen einspielen könnte. Die folgende Tabelle ist deshalb kein Plan, sondern zeigt, was ein Neubau aus Code verlangen würde.
Soll die VM ersetzbar werden, sieht der Weg so aus:
| Was | Heute | Ziel |
|---|---|---|
| Code | im GitLab, sobald gepusht | früh pushen, ein Branch und ein Worktree je Agent |
| Fortschritt eines Agents | nur im Gespräch | als Notiz oder Commit im Repo |
| Gespräche der Agents | ~/.claude auf der VM |
dürfen mit der VM sterben |
| herdr-Layout | session.json auf der VM |
darf sterben, Workspaces sind schnell angelegt |
| Konfiguration von herdr und Claude Code | von Hand auf der VM | im Dotfiles-Repo |
| Toolchain | von Hand installiert | cloud-init für den Host, Dev Container im Projekt |
| Zugangsdaten | auf der VM | bei jedem Neubau neu ausgestellt, eng berechtigt |
| VM | Einzelstück seit dem Sommer | jederzeit neu baubar |
Für Testumgebungen habe ich das im Beitrag über ephemere Testumgebungen durchgespielt: Jede Umgebung entsteht aus demselben AppHost wie die Produktion und verschwindet mit ihrem Pull Request. Nach Fowlers Phoenix-Idee käme der Neubau nicht erst, wenn die Maschine kaputt ist, sondern regelmäßig, damit sich keine unbemerkten Änderungen ansammeln.
Wo mein Setup steht
Die Einleitung hat zwei Fragen gestellt. Wo liegt der Zustand? Bei mir auf der VM, in ~/.claude und in der session.json von herdr. herdr sorgt dafür, dass er einen Neustart übersteht, und macht die VM damit wertvoller. Cloud Native verlangt dagegen festzulegen, was wegwerfbar ist, und alles andere dorthin zu bringen, wo es einen Neubau übersteht, bei mir ins GitLab.
Wer betreibt die Umgebung? Ich. Die Cloud-Agents der Anbieter nähmen mir den Betrieb ab, setzen aber GitHub voraus oder müssen mein GitLab erreichen. Also bleibt die eigene VM, und mit ihr Updates, Backups und Zugänge.
Coding-Agents machen beide Fragen dringlicher. Parallele Agents brauchen getrennte Checkouts, und was ein Agent über eine Sitzung hinaus wissen muss, gehört ins Repo statt ins Gespräch. Das Werkzeug beantwortet keine der beiden Fragen. herdr macht jedes meiner Geräte zum Fenster auf dieselbe Arbeit, die Maschine darunter ist noch eine Schneeflocke. Das darf sie bleiben. Ein Backup, das ich jeden Morgen einspielen könnte, genügt mir, mehr brauche ich nicht.
- 01CNCF Technical Oversight Committee, CNCF Cloud Native Definition v1.1, 2024, sowie PR #1304 mit den Änderungen gegenüber v1.0 von 2018.
- 02Peter Mell, Timothy Grance, The NIST Definition of Cloud Computing (SP 800-145), NIST, 2011.
- 03DORA, Capabilities: Flexible infrastructure, Stand 06/2026, und Capabilities: Platform engineering, Stand 01/2026; DORA / Google Cloud, Accelerate State of DevOps Report 2024, 2024.
- 04Nathen Harvey, Derek DeBellis, Announcing the 2025 DORA Report, Google Cloud, 2025.
- 05Randy Bias, The History of Pets vs Cattle and How to Use the Analogy Properly, 2016.
- 06Martin Fowler, SnowflakeServer und PhoenixServer, 2012; Kief Morris, ImmutableServer, 2013.
- 07Adam Wiggins, The Twelve-Factor App: I. Codebase, VI. Processes, IX. Disposability und X. Dev/prod parity, 2011, zuletzt aktualisiert 2017.
- 08Matthew Skelton, Manuel Pais, Team Cognitive Load, IT Revolution, 2021, Auszug aus Team Topologies, 2019.
- 09Christian Weichel, Alejandro de Brito Fontes, We’re leaving Kubernetes, Gitpod (heute Ona), 2024.
- 10Microsoft, What is Aspire?, Aspire architecture overview und Releases, Stand 09/2026.
- 11herdrdev, herdr v0.9.1: README, CHANGELOG.md, Doku Concepts, Agents, Configuration, Config reference, Integrations, Session state and restore, Persistence and remote access, Connecting machines und CLI reference, dazu der Quellcode src/app/api_helpers.rs, src/app/agent_view.rs, src/agent_resume.rs und src/remote/attach.rs, Stand 09/2026.
- 12Anthropic, Claude Code Docs: Use Claude Code in the cloud, Configure cloud environments, Continue local sessions from any device with Remote Control und Run parallel sessions with worktrees, Stand 09/2026.
- 13Justin Young, Effective harnesses for long-running agents, Anthropic, 2025.
- 14GitHub Docs, About GitHub Copilot cloud agent und Configure the development environment, Stand 09/2026.
- 15Cognition, Devin environment setup, Stand 09/2026.
- 16OpenAI, Codex-Doku: Cloud environments, Best practices und GitLab, Stand 09/2026.
- 17Cursor, Cloud Environment Setup, Cloud Agents: Secrets & Network und GitLab, Stand 09/2026.
Text unter CC BY-SA 4.0, Code-Beispiele unter MIT. Weiterverwendung mit Namensnennung und Link auf diesen Beitrag.